Golvet under en viktig stack
Om att bygga sitt hus på gungfly eller på fast mark.
Det finns två sorters systemadministratörer. De som har förlorat data och de som ännu inte har förstått att de har förlorat data.
Den första gruppen bygger plattformar. Den andra bygger erfarenhet.
Bygger du en stack som spelar roll, även om den bara är en container utan databas, ska den stå på samma golv: två dörrar, en identitet, en agent, en backupväg och en grind före deploy.
Är det en vibe-kodad todolista för dig själv utan hemligheter kan du rotera vidare. Din framtida incidentrapport behöver ingen ytterligare dokumentation.
När är en stack viktig?
Storleken avgör inte. En stack är viktig så fort något av det här gäller, och då ska hela golvet med, även om stacken är en enda container:
- Den går att nå från internet.
- Den hanterar andras data eller konton.
- Den bär hemligheter, som nycklar eller token till andra system.
- Det skulle göra ont att förlora den eller bygga om den ur minnet.
- Någon annan räknar med att den är uppe.
En container som håller en API-nyckel till din bank är viktigare än tjugo som renderar en blogg. En stack utan användare, som en jobbkörare utan API, behöver ingen dörr in. Dörren ut behöver den fortfarande.
Det finns också ett empiriskt test: stäng av stacken och se vem som ringer.
Om ingen ringer är den förmodligen oviktig. Om ekonomichefen ringer har du hittat en affärskritisk tjänst. Om juristen ringer har du hittat ett säkerhetsproblem. Om ingen ringer men företaget går i konkurs tre månader senare har du förmodligen hittat ett integrationssystem.
Plattform och topphatt
Plattformen är det varje viktig stack behöver oavsett vad den gör. Topphatten är allt som gör stacken till just den stacken: koden, databasen, kön, cachen och sökindexet.
Bilindustrin delar upp det så för att bromsarna inte ska behöva konstrueras om för varje modell. Vi som arbetar med IT har en något annorlunda tradition: vi bygger först bilen, börjar köra och upptäcker sedan att bromsarna finns på nästa kvartals roadmap.
Plattformen äger mekanismerna. Topphatten deklarerar vad som ska in i dem och vet inte mer om plattformen än fästpunkterna:
| Fästpunkt | Topphatten | Plattformen |
|---|---|---|
| Loggar och mått | Skriver till stdout, exponerar /metrics, skickar OTLP | Samlar in, lagrar, visar |
| Larm | Loggar en strukturerad larmrad | Gör raden till ett larm |
| Identitet | Läser användare och roller ur headers | Utfärdar token, validerar, sätter headers |
| Routes | Anger route och rollkrav | Släpper bara in det som är registrerat |
| Vägar ut | Anger värdnamnen den behöver | Släpper fram dem, nekar resten och larmar |
| State | Anger vad som är källa | Krypterar, skickar ut ur huset, läser tillbaka |
Delningen går att göra konkret i filer, med plattformen i en egen compose-fil och topphatten i en annan:
Plattformen äger mekanismerna. Topphatten deklarerar vad som ska in i dem och vet inte mer om plattformen än fästpunkterna:
| Fästpunkt | Topphatten | Plattformen |
|---|---|---|
| Loggar och mått | Skriver till stdout, exponerar /metrics, skickar OTLP | Samlar in, lagrar, visar |
| Larm | Loggar en strukturerad larmrad | Gör raden till ett larm |
| Identitet | Läser användare och roller ur headers | Utfärdar token, validerar, sätter headers |
| Routes | Anger route och rollkrav | Släpper bara in det som är registrerat |
| Vägar ut | Anger värdnamnen den behöver | Släpper fram dem, nekar resten och larmar |
| State | Anger vad som är källa | Krypterar, skickar ut ur huset, läser tillbaka |
Delningen går att göra konkret i filer, med plattformen i en egen compose-fil och topphatten i en annan:
docker compose -f platform.yml -f stack.yml up -dPlattformen äger mekanismerna. Topphatten deklarerar vad som ska in i dem och vet inte mer om plattformen än fästpunkterna:
| Fästpunkt | Topphatten | Plattformen |
|---|---|---|
| Loggar och mått | Skriver till stdout, exponerar /metrics, skickar OTLP | Samlar in, lagrar, visar |
| Larm | Loggar en strukturerad larmrad | Gör raden till ett larm |
| Identitet | Läser användare och roller ur headers | Utfärdar token, validerar, sätter headers |
| Routes | Anger route och rollkrav | Släpper bara in det som är registrerat |
| Vägar ut | Anger värdnamnen den behöver | Släpper fram dem, nekar resten och larmar |
| State | Anger vad som är källa | Krypterar, skickar ut ur huset, läser tillbaka |
Delningen går att göra konkret i filer, med plattformen i en egen compose-fil och topphatten i en annan:
docker compose -f platform.yml -f stack.yml up -dAlternativet är include: överst i topphattens fil (Compose 2.20 eller senare). Med -f slås filerna ihop och topphatten kan skriva över plattformen. Med include behåller plattformen sina egna sökvägar, och en krock blir ett fel i stället för en tyst överskrivning. YAML-ankare följer inte med över filgränsen i något av fallen, så det som ska återanvändas får gå via extends.
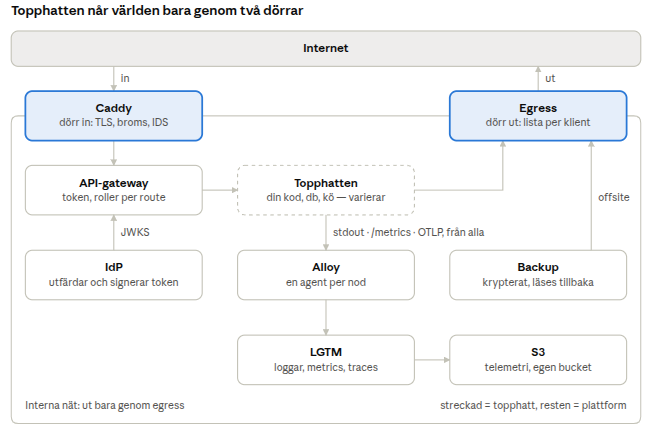
Allt utom den streckade rutan är plattform och ser likadant ut i varje stack. Topphatten nås bara genom gatewayn och når ut bara genom egress.
Två dörrar
En viktig stack har två dörrar mot världen, kanten in och utgången ut. Allt annat sitter på interna nät utan väg ut och utan extern DNS.
- Dörren in är en reverse proxy med TLS. Certen sköts automatiskt. Här bromsas varje klient, och den som beter sig illa bannas innan den når din kod.
- Dörren ut är en namnport. Den läser värdnamnet ur TLS-handskakningen och släpper bara fram det som står på klientens lista. TLS lämnas orörd, och nekade försök larmar.
- Interna nät efter roll, till exempel publikt, backend, data och observability. En tjänst sitter bara på de nät den behöver.
- Den som tar emot trafik utifrån har helst ingen väg ut. Måste något hämtas utifrån gör en worker det och lägger resultatet där API:t kan läsa det. En komprometterad container utan väg ut är fortfarande ett problem, men åtminstone ett problem som får stanna hemma. Det är skillnaden mellan att ha en tjuv i källaren och att ge honom nycklarna till firmabilen.
- Undantag läggs till ett i taget, och vart och ett har ett skrivet skäl.
Utgående trafik är det enda lager som stoppar ett kapat beroende, oavsett hur det kom in. Ett filter som känner igen elaka mål räcker inte, eftersom adresser och namn går att dölja. Klienten ska sakna väg, inte bli nekad. Priset är att varje ny extern destination blir ett medvetet beslut, och det är meningen.
| Dörr | Förslag | Alternativ och avvägning |
|---|---|---|
| In | Caddy | Traefik, eller nginx + certbot. Caddy ger automatiska cert och plugins i en binär |
| Ut | nginx stream med en lista per klient | Squid med HTTP CONNECT kräver att klienten använder proxyn. Brandväggsregler per IP håller inte när adresser byts. Service mesh hör hemma i Kubernetes |
Muren stoppar inte allt. Ett tillåtet mål som delas av många, som en S3-tjänst där angriparen har en egen bucket, är fortfarande en väg ut.
Identitet
En utfärdare signerar alla token, och en gateway validerar dem. Fästpunkten är standarden, inte produkten: med OIDC, JWKS och roller i token går IdP:n att byta utan att tjänsterna märker det.
- Bara IdP:n har privata nycklar. Den roterar dem och publicerar de publika som JWKS, och allt annat validerar.
- Gatewayn släpper bara in det som är registrerat. Varje route har sitt rollkrav, och en route som inte är registrerad finns inte. Användare och roller går vidare som headers, så koden aldrig parsar en token.
- Rollkontrollen görs på ett ställe. Koden kontrollerar bara det gatewayn inte kan uttrycka, som ägarskap. Två ställen att hålla i synk driftar isär.
- Standarder hela vägen: OAuth Code + PKCE, OIDC-scopes och ett strikt
aud. Ett eget flöde är en underhållsrisk för alltid. - Inloggningen skyddar sig själv. Samma svar oavsett om kontot finns, plus captcha, rate limit och säkerhetshändelser som detekteringen kan läsa.
- Konto är inte medlemskap. Delar flera appar på en IdP ger signup bara ett konto. Varje app delar ut sina roller när användaren loggar in där.
| Del | Förslag | Alternativ och avvägning |
|---|---|---|
| IdP | Keycloak eller Zitadel | Authentik; Ory Hydra + Kratos; en molntjänst som Auth0 eller Entra ID. Bygg en egen bara om du vill lära dig, för då blir varje säkerhetsdetalj din. Det finns enklare sätt att skaffa sig ett livslångt åtagande, men få som erbjuder lika många möjligheter att göra ett katastrofalt misstag med kryptografi. |
| Gateway | KrakenD, eller Caddy med JWT-plugin så att kant och gateway blir en | Envoy; APISIX. Kontrollera vad gratisutgåvan saknar: i Traefik ligger JWT bakom betalvägg, och KrakenD flyttar funktioner till sin betalutgåva |
Observability – skrikande tystnad
Tjänsterna vet ingenting om övervakningen. De loggar till stdout, exponerar /metrics och skickar OTLP, och en agent per nod tar det vidare till en LGTM-stack som lagrar i S3.
- En agent per nod, inte per källa. Alloy samlar in på maskinen där källan finns. Går stacken från en till flera maskiner ändras bara agentens destination.
- Fyra signaler. Loggar hamnar i Loki, metrics i Prometheus och traces i Tempo, och vid behov profiler i Pyroscope. Grafana visar alltihop.
- S3 bär det mesta. Loki och Tempo lagrar i S3, men Prometheus använder lokal disk. Mimir behövs först när metrics också ska ligga i S3 eller sparas länge. Telemetrin får en egen bucket med eget konto, och retentionen ställs i bucketen.
- Larm har en väg. Rulers i Prometheus och Loki skickar till Alertmanager. En app som vill larma loggar en strukturerad rad och känner aldrig till Alertmanager.
- Bara entydiga larm. Ett larm som brusar lär folk att ignorera alla larm. Efter några veckor har du byggt en mycket avancerad maskin som producerar ljud ingen lyssnar på. Brandvarnaren har blivit bakgrundsmusik.
När det väl börjar brinna fortsätter orkestern spela. - Healthchecks styr startordningen, inte övervakningen. En statussida räknas ur mätvärden och aktiva larm, inte ur egna pingar.
- Allt som kod. Dashboards, datakällor och larmregler ligger i git.
Etiketter är ett kontrakt. Larm matchar på etiketter som job och instance, och byts mätkällan så att de ändras slutar larmet matcha. En tom graf syns, men ett tyst larm gör det inte. Det senare upptäcker man vanligtvis först när någon frågar varför ingen visste något.
Då är det praktiskt att ha en bra ursäkt. En fungerande larmkedja är dock att föredra.
| Alternativ till LGTM + Alloy | Avvägning |
|---|---|
| Grafana Cloud | Samma verktyg utan drift, men datan lämnar stacken och kostnaden följer volymen |
| SigNoz eller OpenObserve | Allt i ett ovanpå OpenTelemetry med färre rörliga delar, men mindre ekosystem |
| Elastic eller OpenSearch | Bättre fritextsök i loggar, men tyngre att drifta |
| OpenTelemetry Collector i stället för Alloy | Leverantörsneutral agent, samma roll |
Backup
En backup finns först när den har lästs tillbaka. Fram till dess är den en religiös övertygelse.
Det finns gott om administratörer som ber till sin backup varje natt. De flesta får aldrig veta om deras böner blir hörda förrän det är för sent.
Plattformen äger mekanismen, och topphatten säger vad som ska med.
- Topphatten deklarerar sina källor: databasen, objektlagringen och annat som inte går att bygga om. Sökindex, cache och annat härlett byggs om ur källan i stället.
- Plattformen är sin egen första kund. IdP:ns konton och nycklar ska med, så backupen har alltid något att göra, även i en stack utan databas. Telemetrin får däremot åldras ut.
- Krypterat och utanför huset. Backupen krypteras innan den lämnar maskinen och går genom dörren ut till ett annat ställe än stacken.
- Metadata före data. När två delar hör ihop tas den som pekar före den som pekas på, så att den aldrig pekar på något som saknas.
- Återläsning i värsta läget. Testet hämtar den riktiga backupen utan lokal kopia och läser in den i nya kopior av tjänsterna på ett eget internt nät. Sedan kontrollerar det varje del och river allt. Ett nytt steg i backupen kräver en ny kontroll.
En backup som aldrig återlästs är som en fallskärm som aldrig packats upp. Det kan mycket väl finnas något där inne, men första gången du behöver ta reda på det är ett illa valt tillfälle. - Skriv ned rötterna. Krypteringsnyckeln, kontot där backupen ligger och kontot där koden ligger måste överleva maskinen. De ska stå i en återuppbyggnadsplan, inte i någons huvud.
- Ny volym vid migrering. Fylls en datavolym på nytt får den ett nytt namn, och den gamla står kvar som reträtt.
| Förslag | Alternativ och avvägning |
|---|---|
| restic mot S3-kompatibel lagring, med rclone för andra mål | Borg vill ha en Borg-server i andra änden. Kopia har UI och policyer. Ögonblicksbilder i ZFS eller Btrfs är snabba men lämnar inte huset av sig själva |
| Nattlig backup | Kontinuerlig arkivering av binlog eller WAL när ett dygns förlust är för mycket |
Grundsäkerhet
Säkerhet är att förstå dörrarna, inte att nå noll CVE. Det går utmärkt att ha en fullständigt uppdaterad, välskannad och komprometterad server. Den har åtminstone fördelen att säkerhetsrapporten ser bra ut.
Ett fynd väger efter vad en angripare redan måste ha för att nå det, och plattformen ger fyra saker som gör den bedömningen möjlig.
- Veta vad som skeppas. Pinna allt, både images och paket, och använd aldrig
:latest– det är inte en version. Det är ett löfte om att morgondagen blir annorlunda, utan någon garanti för att den blir bättre.
Skriv en SBOM per image. Det skannern inte ser, som en nedladdad binär, deklareras i Dockerfilen. - Ta det långsamt in. En version är mogen när den har stått still i några dagar och har lite nedladdningar, även en säkerhetsfix, eftersom ett kapat säkerhetssläpp är en klassisk väg in. Majors tas för hand. Läs lockfilens diff före merge, och granska nya install-skript och nya beroenden som är unga eller liknar kända namn.
- Se intrång. En IDS vid dörren in läser accessloggen och bannar per IP. Runtime-detektering på varje nod ser systemanropen, till exempel när en container försöker ta sig ut.
- Hemligheter bor aldrig i koden. De injiceras via env från en katalog utanför git, och varje tjänst får bara sina egna. Config-repona är fria från hemligheter.
En gång i veckan ställs två frågor: vad kan uppdateras, och vad av det når en angripare? Svaret vägs mot en karta över attackytorna, från internet in till värden. Få beroenden hör också hit, eftersom varje paket du inte har är ett du inte behöver granska.
Var står angriparen?
Varje fynd placeras på en stege efter vad angriparen redan måste ha för att nå det. Ju högre upp på stegen, desto tyngre väger fyndet, och varje lager i plattformen håller emot på sin nivå.
| Nivå | Angriparen har | En CVE här | Plattformen svarar med |
|---|---|---|---|
| N1 Internet | En webbläsare | Väger tyngst: allt som tar emot anonym data | Dörren in: TLS, rate limit, IDS |
| N2 Inloggad | Ett konto, även gäst | Tungt: allt bakom inloggningen | Gatewayn: rollkrav per route |
| N3 LAN | En maskin på nätet runt värden | Beror på vad som lyssnar på värdens adresser | Inga publicerade portar utom dörren in |
| N4 Internt nät | Kodkörning i en container | Medel: det containern når på sina nät | Segmentnäten och dörren ut |
| N5 Containern | Ett skal i containern | Lätt: angriparen är redan inne | Runtime-detektering |
| N6 Värden | Ett skal på värden | Spelar ingen roll: allt är redan förlorat – maskinen går inte att lita på ¯\_(ツ)_/¯ | Backup utanför huset och återuppbyggnadsplanen |
Ett paket som ingen process laddar hamnar i N5, oavsett allvarsgrad. Det är ett verktyg efter ett intrång, inte en väg in. Tio CRIT där väger mindre än ett HIGH i en parser på N1.
På N6 har säkerhetsarbetet bytt disciplin. Vi ägnar oss inte längre åt prevention utan åt arkeologi. Maskinen är en brottsplats och det enda vi egentligen vet är att vi inte längre vet vad den gör.
Det är därför vi har backup. Förhoppningsvis.
Nivåerna kan glida ihop. Delas gäst-token ut utan inloggning är N2 i praktiken N1, och en databasport som är öppen mot LAN ger den som står på N3 det som annars kräver N4.
| Område | Förslag | Alternativ och avvägning |
|---|---|---|
| IDS vid dörren in | CrowdSec med bouncer i kanten | fail2ban är enklare men värdlokal. En WAF som Coraza ser innehållet men brusar |
| Runtime | Falco | Tetragon kan även stoppa, inte bara se. auditd finns överallt men är svår att läsa |
| Hemligheter | Filer via env_file | SOPS/age ger krypterade hemligheter i git. Vault eller OpenBao ger rotation, men är en tjänst till att drifta |
| Inventering | Trivy, CycloneDX | Syft + Grype. Dependency-Track följer SBOM:erna över tid |
| Uppdateringar | Renovate med mognadstid | Dependabot. En egen rutin om du vill ha en grind som läser install-skripten |
Leverans
En viktig stack går att bygga om från en ren klon och hålls aktuell utan att någon behöver minnas hur.
- Basfilen är prod, dev är ett tillägg. Allt dev-specifikt, som öppna portar och lokala cert, ligger i en override. Med plattformen i en egen fil blir det fyra filer: plattform och stack, var och en med sin dev-override.
- Publika namn ur en variabel. Domänen sätts på ett ställe, och koden känner inga domäner.
- En grind före deploy. Den kör testerna och validerar compose. Den validerar också varje tjänsts egen config med tjänstens egen image, eftersom compose inte läser monterade configfiler.
Faller grinden blir det ingen release. Det kan kännas frustrerande när allt fungerar på utvecklarens dator, men användarna har visat en märklig ovilja att flytta in i just den datorn. - Tjänster hämtar aldrig själva i drift. Modeller, plugins och liknande hämtas vid bygget och läses från skrivskyddade volymer. Imagen innehåller kod, och det som inte är kod ligger i volymer.
- Resursgränser per tjänst. Med ett minnestak per tjänst fäller en läcka en container, inte maskinen.
- Compose-filen är systemmodellen. Varje tjänst anger vilka den pratar med, vilka mål ute den behöver och var den är dokumenterad. Grafen, statussidan och kontrollerna läses ur samma fil, så de inte driftar isär.
| Fråga | Förslag | Alternativ och avvägning |
|---|---|---|
| Orkestrering | Docker Compose | Kubernetes eller k3s ger schemaläggning och självläkning över många noder, men mycket mer att äga. Nomad ligger mittemellan |
| Repon | Ett repo per byggbar tjänst | Monorepo gör tvärgående ändringar atomära. Det viktiga är tydliga gränser, inte antalet repon |
| Grind | Lokalt skript före release | CI kör oberoende av maskinen men kostar tid per commit |
Byggordning
Bygg det som är dyrast att lägga till i efterhand först, så att första tjänsten föds bakom muren, observerad och säkerhetskopierad. En mur som byggs i efterhand måste stängas en tjänst i taget. En tjänst som har kört utan observability har redan haft fel som ingen såg.
Det betyder inte att felen inte inträffat, bara att du saknar bevis. En omständighet som kan vara tillfälligt trösterik men sällan överlever mötet med verkligheten.
- Grunden: plattformsfilen, en katalog för hemligheter, pinnade versioner och en grind före deploy.
- Näten och dörrarna: interna nät, kanten in och utgången ut med en tom lista.
- Observability: agent, backend och larmväg, innan första tjänsten.
- Identitet: IdP och gateway med deny by default, innan första routen.
- Backup: med IdP:n som första kund och en första återläsning, innan första riktiga data.
- Topphatten.
Allt behöver inte vara på plats dag ett:
| Område | Dag ett | När stacken växer |
|---|---|---|
| Dörr in | Caddy med automatiska cert | + rate limit per klient och IDS |
| Dörr ut | Interna nät, utgång med lista | + larm på nekade försök och runtime-detektering |
| Identitet | Färdig IdP, gateway med rollkrav | + rate limit per användare, medlemskap per app |
| Observability | Alloy, Loki, Prometheus, Grafana, Alertmanager | + traces, profiler, RUM och statussida |
| Backup | Nattlig, krypterad, utanför huset, återläst minst en gång | + schemalagd återläsning av en hel natt i en egen stack |
| Säkerhet | Pinning, hemligheter via env, sju dagars mognad | + SBOM, granskning av lockfiler, veckosvep |
| Leverans | Basfil = prod, grind före deploy | + systemmodell med genererad graf och kontroller |
Inköpslistan: platform.yml
Här är ett exempel på plattformen som en compose-stub med tjänsterna, en vald image per tjänst, startordningen och näten. Config, volymer och portar fylls i per stack. Versionerna är exempel som var pinnade i oktober 2026, så pinna om dem när du bygger.
# platform.yml — inköpslistan: namn, image, depends_on och nät.
# Config, volymer och portar fylls i per stack.
#   docker compose -f platform.yml -f stack.yml up -d

x-internet: &internet
  gw_priority: -1     # internet sist: default-gateway, men DNS svarar ur de interna näten

services:
  # --- Dörrarna --------------------------------------------------
  caddy:              # dörr in: TLS, rate limit, CrowdSec-bouncer
    build: ./caddy    # FROM caddy:2.11.4, byggd med xcaddy för plugins
    networks:
      public:
      observability:
      internet: *internet
  egress:             # dörr ut: lista med värdnamn per klient
    image: nginx:1.31.6-alpine
    networks:
      internet: *internet
      out-crowdsec:
      out-backup-runner:
      # + ett out-<klient> per topphattstjänst som behöver ut, i stack.yml

  # --- Identitet -------------------------------------------------
  idp:                # egen, eller Keycloak/Zitadel som image
    build: ./idp
    depends_on: [db, redis, mailer]
    networks: [public, datastore, observability]
  gateway:            # validerar token, rollkrav per route
    image: krakend:3.0.0
    depends_on: [idp] # + topphattens api, i stack.yml
    networks: [public, backend, observability]
  mailer:             # SMTP-relä för IdP och Alertmanager
    build: ./mailer   # SMTP saknar SNI: en egen väg ut, med skäl
    networks:
      public:
      observability:
      internet: *internet

  # --- Plattformens eget state ----------------------------------
  db:                 # IdP:ns lagring. Topphatten har sin egen
    image: mysql:8.4.11
    networks: [datastore]
  redis:              # IdP:ns sessioner
    image: redis:8.10.2
    networks: [datastore]
  s3:                 # telemetrins lagring
    image: pgsty/silo:RELEASE.2026-09-16T00-00-00Z
    networks: [datastore]

  # --- Observability ---------------------------------------------
  alloy:              # agent per nod
    image: grafana/alloy:v1.20.1
    depends_on: [loki, tempo, prometheus]  # allt den skriver till
    networks: [observability, datastore]
  loki:
    image: grafana/loki:3.7.8
    depends_on: [s3]
    networks: [observability, datastore]
  tempo:
    image: grafana/tempo:3.1.0
    depends_on: [s3, prometheus]  # metrics-generatorn skriver till Prometheus
    networks: [observability, datastore]
  prometheus:
    image: prom/prometheus:v3.15.0
    depends_on: [alertmanager]
    networks: [observability]
  alertmanager:
    image: prom/alertmanager:v0.34.1
    networks: [observability]
  grafana:
    image: grafana/grafana:13.2.3
    networks: [observability]
  node-exporter:
    image: prom/node-exporter:v1.12.1
    network_mode: host  # mäter värden, nås via observability-gatewayen
  cadvisor:
    image: gcr.io/cadvisor/cadvisor:v0.55.1
    networks: [observability]

  # --- Säkerhet --------------------------------------------------
  falco:              # runtime-detektering, en per nod
    image: falcosecurity/falco:0.45.0
    networks: [observability]
  crowdsec:           # IDS: kantens accesslogg + IdP:ns händelser
    image: crowdsecurity/crowdsec:v1.8.1
    depends_on: [egress, loki]  # hubben via egress, IdP-källan via Loki
    networks: [observability, out-crowdsec]

  # --- Backup ----------------------------------------------------
  backup-runner:      # restic + rclone (rclone/rclone:1.75.1) mot offsite
    build: ./backup-runner
    depends_on: [db]
    networks: [datastore, observability, out-backup-runner]

networks:             # alla internal utom internet
  public:            { internal: true }
  backend:           { internal: true }
  datastore:         { internal: true }
  observability:     { internal: true }
  internet:          {}  # bara dörrarna och skrivna undantag
  out-crowdsec:      { internal: true }  # ett per klient, delat bara med egress
  out-backup-runner: { internal: true }
depends_on gör två jobb: startordning och stoppordning. Alloy beror på allt den skriver till, så den stoppas först och målen står kvar tills den har skickat klart. På samma sätt står S3 kvar tills Loki och Tempo har skrivit sitt.
Valet av IdP styr databasen. Keycloak klarar MySQL, men Zitadel och Authentik kräver PostgreSQL. Vilken det blir spelar mindre roll än att den finns med från start, eftersom den är backupens första kund.
När allt ändå går åt h*lv*t*
Inget av det här gör din stack osårbar.
Det finns alltid ett säkerhetshål du inte känner till, ett beroende vars utvecklare plötsligt upptäckt att kryptovalutor är mer lönsamma än öppen källkod, eller en administratör som en fredagseftermiddag bestämmer sig för att städa bland Docker-volymerna.
Förr eller senare kommer någonting att gå sönder. Det är inte en fråga om pessimism utan om statistik. Murphy arbetar dygnet runt och har aldrig begärt semester.
Poängen med plattformen är inte att förhindra varje katastrof. Det är att begränsa dess omfattning, upptäcka den medan det fortfarande finns något kvar att rädda och ha en väg tillbaka när allt annat har misslyckats.
En bra plattform gör inte att du slipper skriva incidentrapporter.
Den gör att du fortfarande har ett system att skriva dem om.
Och med lite tur behöver du inte skriva dem från arbetsförmedlingens dator.