Från brus till öra
Om en musikspelare som kunde hitta liknande låtar, men inte riktigt förstod vad jag menade. Och om en ganska lång omväg för att lära den skillnaden.
När matematiken och örat inte är överens
Min hemsnickrade musikspelare har länge haft en ganska imponerande förmåga. Jag kan spela en låt, be den hitta fler som liknar den, och få tillbaka en lista med musik som på något sätt hör ihop.
Ofta fungerar det alldeles utmärkt.
Men ibland sitter jag där och undrar vad den egentligen håller på med.
Det är inte så att förslagen är fullständigt vansinniga. Tvärtom. De hör ofta hemma i samma genre, har liknande instrumentering och kanske till och med samma slags sångare. På papperet är de utmärkta kandidater.
Problemet är bara att de inte låter särskilt lika.
Och omvänt kan två låtar som för mina öron är närmast kusligt lika ligga långt ifrån varandra i musikspelarens matematiska universum.
Det var irriterande.
Inte minst eftersom jag visste hur systemet fungerade. Varje låt hade analyserats av en AI-modell som heter CLAP och förvandlats till en matematisk representation. Låtar som modellen uppfattar som lika hamnar nära varandra i en mångdimensionell rymd.
Tänk dig ett gigantiskt bibliotek där böckerna inte står sorterade efter författare eller titel, utan efter innehåll. Kärleksromaner i ett hörn, deckare i ett annat och filosofiska traktater någon annanstans.
CLAP hade byggt ett sådant bibliotek åt mig, fast med musik.
Och det fungerade.
Ända tills jag började bry mig om exakt vilken bok som stod närmast vilken.
Det visade sig vara en betydligt svårare fråga.
Ett problem med Guns N’ Roses
En av de låtar som fick fungera som försökskanin var Guns N’ Roses låt Don’t Cry.
Det är en låt som börjar ganska försiktigt, med en akustisk gitarr, innan den successivt växer till något betydligt större. En klassisk rockballad, om man så vill.
När jag bad musikspelaren hitta liknande låtar fick jag förstås andra rockballader.
Men ordningen var märklig.
Olika utgåvor av samma låt kunde hamna på olika platser. Alice Coopers Poison dök upp flera gånger, men utspridd över listan. Och låtar som jag själv uppfattade som ganska lika kunde ligga långt ned, medan andra, mindre övertygande kandidater placerades högre.
Det första jag misstänkte var att något hade gått snett när musiken analyserades.
Och mycket riktigt hittade vi en liten överraskning.
En del av CLAP ljudbearbetning innehöll ett slumpmoment som innebar att samma ljud inte alltid gav exakt samma resultat. Det var inte något katastrofalt fel, men tillräckligt för att störa jämförelser där skillnaderna redan var mycket små.
Det rättade vi till.
Sedan gjorde vi om analysen.
Och problemet fanns fortfarande kvar.
Det var då jag började inse att det kanske inte var något fel på CLAP.
Vi hade bara bett modellen göra något som den inte var särskilt bra på.
Den kunde tala om vilka låtar som bodde i samma kvarter. Men den kunde inte nödvändigtvis tala om vilka grannar som faktiskt liknade varandra mest.
Hur en AI jämför musik
CLAP omvandlar ljud till vektorer, alltså långa listor med tal. I mitt fall representeras varje låt av 512 värden.
Genom att jämföra vektorerna kan man beräkna hur lika två låtar är enligt modellen.
Musikspelaren använder databasen Milvus för att snabbt hitta närliggande vektorer bland alla låtarna.
Det viktiga är att avståndet beskriver modellens uppfattning om likhet, inte någon objektiv musikalisk sanning.
En modell kan vara mycket konsekvent och ändå konsekvent mäta fel sak.
Kanske lyssnade vi på fel del?
En möjlig förklaring var hur låtarna representerades.
Musikspelaren analyserade inte varje sekund av en låt. I stället valdes kortare avsnitt från början, mitten och slutet. Resultaten slogs sedan samman till en gemensam representation.
Det är en praktisk lösning. En låt på tre minuter behöver inte nödvändigtvis analyseras i sin helhet för att man ska kunna säga något om dess karaktär.
Men vad händer med en låt som förändras?
Ta Helloweens låt Keeper of the Seven Keys.
Det är ett långt stycke med flera tydligt olika delar. Det börjar på ett sätt, utvecklas åt ett annat håll och hinner passera ytterligare musikaliska landskap innan det är slut.
Vad betyder det egentligen att en annan låt liknar Keeper of the Seven Keys?
Liknar den inledningen? Den snabba delen? Något riff mitt i? Eller är det den samlade upplevelsen vi jämför?
En genomsnittlig representation av låten riskerar att dölja just de detaljer som gör den intressant.
Så vi provade att behålla delarna var för sig.
Plötsligt kunde vi fråga musikspelaren något mycket mer specifikt: Vilka låtar har en inledning som liknar den här? Eller en mittsektion?
Det gav en del intressanta resultat.
En lugn gitarrinledning kunde hitta andra låtar som började med samma slags gitarrspel. Men det var inte säkert att de fortsatte åt samma håll.
Vi upptäckte också att olika delar av en låt levde i ganska olika matematiska landskap. Ett avstånd som var stort när man jämförde inledningar kunde vara helt normalt när man jämförde hela låtar.
Och när vi försökte kombinera delarna på olika sätt blev resultatet inte självklart bättre.
Vi hade fått fler sätt att räkna.
Men fortfarande inget säkert sätt att avgöra vilket som var rätt.
Det började bli uppenbart att vi behövde en domare.
Någon som inte brydde sig om vektorer, databaser eller hur elegant algoritmen var.
Någon med öron.
Att ställa frågan till rätt person
Det låter kanske självklart att man ska lyssna på musik när man bygger en musikrekommendationstjänst.
Men det är förvånansvärt lätt att fastna i siffrorna.
En modell ger ett värde. En annan ger ett lite högre värde. En tredje producerar en snyggare fördelning. Man gör diagram, räknar korrelationer och justerar parametrar.
Till slut har man en imponerande samling mätresultat.
Utan att nödvändigtvis veta om musiken låter bättre.
Så vi byggde ett lyssningsprov direkt i musikspelarens utvecklingsversion.
Upplägget var enkelt.
Jag fick en låt att utgå från och ett antal förslag på sådant som kunde tänkas likna den. För varje förslag kunde jag ge tumme upp eller tumme ned.
Men jag fick inte veta vilken metod som hade valt låten.
Det var viktigt.
Om jag redan visste att en låt kom från den nya, lovande metoden skulle jag förmodligen lyssna efter det som gjorde den bra. Och om jag visste att den kom från den gamla metoden skulle jag kanske vara mer benägen att hitta fel.
Människor är ganska skickliga på att bekräfta sina egna förväntningar.
Jag är knappast något undantag.
Vi blandade därför förslagen från olika metoder, lade till några slumpmässigt valda låtar som kontroll och lät dessutom vissa jämförelser återkomma senare i provet.
Det sista var ett sätt att kontrollera domaren.
Om jag gav samma musikpar tumme upp ena gången och tumme ned nästa, skulle vi ha ett problem. Då vore det kanske inte modellen som var inkonsekvent.
Men örat visade sig vara ganska stabilt.
Det var modellerna som hade problem.
Ett blindtest för musik
Det första provet omfattade 60 utgångslåtar och närmare 300 bedömningar.
Förslagen hämtades från två olika sätt att använda CLAP, kompletterade med slumpmässiga kontrollåtar.
Bedömningen gjordes utan att jag visste vilken metod som föreslagit vad. Några jämförelser återkom för att kontrollera hur konsekvent jag bedömde dem.
Resultatet var ganska brutalt: båda metoderna var betydligt bättre än att välja musik helt slumpmässigt, men inom gruppen av redan liknande låtar var deras inbördes ordning nästan slumpmässig.
Örat däremot gav samma bedömning vid de flesta upprepningar.
Det fanns alltså något konsekvent i min uppfattning om musikalisk likhet som modellerna inte lyckades fånga.
När grannskapet inte räcker
Det första lyssningsprovet gav en ganska nedslående insikt.
CLAP var bra på att hålla fullständigt orelaterad musik borta från förslagen.
Om jag lyssnade på en rockballad började den inte rekommendera slumpmässig dansmusik, jazz eller death metal.
Det var ju bra.
Men när modellen väl hade hittat rätt grannskap blev den osäker.
En låt som låg mycket nära i vektorrymden var inte nödvändigtvis mer lik än en som låg betydligt längre bort.
Det påminde lite om att fråga en bibliotekarie efter böcker som liknar Sagan om ringen.
Bibliotekarien kan utan större problem peka ut fantasyavdelningen.
Men om han sedan rangordnar alla böcker där efter hur lika de är Sagan om ringen, kan resultatet bli ganska egendomligt.
Är en bok med alver och dvärgar automatiskt mer lik än en berättelse som saknar båda men har samma ton, tematik och känsla?
Det beror på vad vi menar med lik.
Och det var här hela projektet började ändra karaktär.
Jag hade försökt hitta en bättre matematisk metod för att jämföra låtar.
Nu började jag i stället undra om det fanns någon annan modell som hade lärt sig att lyssna på musik på ett annat sätt.
Flera öron hör olika saker
Vi började prova andra modeller.
Först en större variant av CLAP, mer specialiserad på musik.
Det lät lovande. Mer specialiserad träning borde väl ge bättre musikförståelse?
Inte nödvändigtvis.
Den större modellen visade sig inte vara någon tydlig förbättring. På vissa sätt var den till och med sämre på att skilja orelaterad musik åt.
Sedan provade vi MuQ, en modell som tränats för att lära sig musikaliska strukturer utan samma koppling till text som CLAP.
Här dök något intressant upp.
Jag hade hittat en video med titeln 20 Songs That Sound EXACTLY The Same. Den innehöll exempel på låtar som delar slående lika musikaliska partier.
För ett mänskligt öra kan likheten ibland vara uppenbar. Samma typ av melodifras, nästan samma riff eller en musikalisk figur som verkar ha vandrat från en låt till en annan.
CLAP var inte särskilt imponerad.
MuQ däremot kunde i ett av försöken hitta den andra låten bland mängder av alternativa ljudavsnitt.
Plötsligt hade vi något att fundera över.
Kanske var det inte så att den ena modellen hörde bättre än den andra.
Kanske hörde de olika saker.
CLAP tycktes framför allt känna igen en låts övergripande karaktär. MuQ kunde i vissa situationer känna igen mer specifika musikaliska detaljer.
Det var skillnaden mellan att konstatera att två personer talar samma språk och att upptäcka att de just uttalat nästan samma mening.
Men MuQ hade ett praktiskt problem.
För att utnyttja den förmågan fullt ut skulle vi behöva analysera stora mängder små ljudavsnitt från hela musiksamlingen.
Det handlade inte längre om att räkna några timmar.
Det började snarare likna ett projekt för flera månader. Jag har tyvärr ingen rigg med ett antal kraftfulla GPU:er att luta mig på utan ett enda betydligt blygsammare grafikkort.
Och även om ett sådant experiment hade varit intressant, var det inte riktigt vad jag hade tänkt mig när jag ville förbättra knappen Fler som denna.
Så vi fortsatte leta.
Ett öra från skivaffären
Nästa kandidat var Discogs-EffNet.
Till skillnad från CLAP hade den här modellen inte som huvudsaklig uppgift att förstå sambandet mellan text och ljud.
Den hade i stället tränats på musikaliska samband hämtade från Discogs, den enorma databasen över skivor, artister, utgåvor och musikstilar.
Man skulle kunna säga att CLAP hade lärt sig lyssna genom att läsa beskrivningar av musik.
EffNet hade snarare gått i skivaffär.
Och det visade sig göra skillnad.
Tänk dig en skivaffär där rock och metal står i samma stora avdelning.
För en oinvigd kan det verka rimligt att placera all hård musik på ungefär samma ställe.
Men den som tillbringat lite tid bland skivhyllorna vet att avståndet mellan symfonisk metal, power metal, traditionell heavy metal och metalcore kan vara ganska betydande.
Inte nödvändigtvis för att den ena är mer eller mindre hård än den andra.
Utan för att de låter olika.
Det var just den skillnaden EffNet verkade fånga.
När jag utgick från Dynazty kunde CLAP föreslå Pain. På ett övergripande plan går det att förstå varför: båda hör hemma någonstans i den hårdare musikens landskap.
Men EffNet föreslog Temperance.
Och där började vi närma oss något som faktiskt lät rätt.
Samma sak hände med andra låtar.
För Sabaton kunde CLAP hitta musik från helt andra undergenrer, medan EffNet oftare höll sig närmare det speciella musikaliska uttryck jag var ute efter.
Det var inte perfekt.
Men för första gången verkade en annan modell konsekvent förstå en del av det som CLAP missade.
En intressant detalj var att EffNet ibland föreslog fler låtar av samma artist.
Det skulle förstås kunna betraktas som ett problem. Om modellen bara hittar låtar av samma artist har man kanske inte kommit särskilt långt.
Men är det verkligen fel?
Status Quo låter ofta som Status Quo. Iron Maiden har ett ganska igenkännbart sound. Och Sabaton behöver sällan särskilt många takter för att avslöja vilka de är.
Om en artist har ett mycket karakteristiskt musikaliskt uttryck är det inte konstigt att flera av artistens låtar faktiskt liknar varandra.
Det viktiga är inte att förhindra sådana rekommendationer.
Det viktiga är att de är bra.
Och den frågan tänkte jag fortsätta avgöra med öronen.
Ett andra försök – och en vinnare
Det första lyssningsprovet hade visat att EffNet verkade lovande.
Men det fanns ett problem.
Vi hade provat flera modeller och många olika inställningar. När man gör tillräckligt många jämförelser kommer någon nästan alltid att se bäst ut, även om skillnaden egentligen beror på slumpen.
Det är lite som att kasta tärning med ett dussin olika tärningar och sedan förklara den som fick flest sexor som magisk.
Så vi behövde ett nytt prov.
Den här gången bestämde vi i förväg exakt vad som skulle jämföras och hur resultatet skulle bedömas.
Vi valde nya låtar och artister som inte hade varit med i det första försöket.
CLAP fick föreslå sitt grannskap, och sedan jämförde vi dess egen rangordning med den ordning EffNet föreslog.
Återigen fick jag lyssna utan att veta vilken metod som låg bakom förslagen.
Och nu blev skillnaden tydlig.
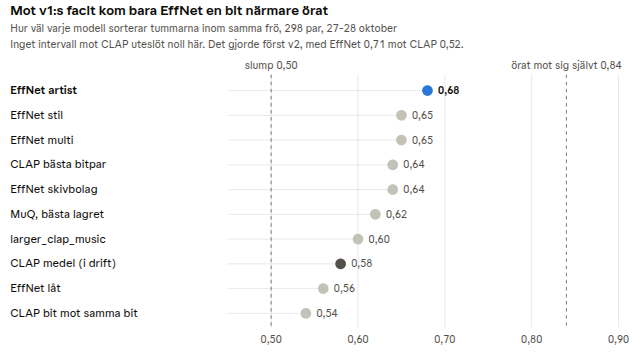
CLAP fortsatte att göra ett bra jobb med att hitta musik som hörde hemma i ungefär samma område.
Men inom detta område var dess rangordning fortfarande inte mycket bättre än slumpen.
EffNet däremot lyckades betydligt bättre med att placera de låtar jag faktiskt tyckte lät lika högre upp.
Skillnaden var tillräckligt tydlig för att vi inte längre skulle behöva förklara den med tur.
Det var ett sådant där ögonblick när en ganska lång rad experiment plötsligt börjar bilda ett begripligt mönster.
Vi behövde inte ersätta CLAP.
Vi behövde komplettera den.
CLAP skulle fortsätta göra det den var bra på: hitta grannskapet.
EffNet skulle få en smalare uppgift: bestämma vilka av grannarna som verkligen hörde ihop.
Två modeller. Två olika slags musikaliskt gehör.
Och plötsligt en mycket bättre rekommendationslista.
Vad visade det andra provet?
Det andra blindtestet använde 60 nya utgångslåtar och jämförde CLAP rangordning med EffNets inom samma kandidatgrupp.
EffNet var tydligt bättre på att skilja mellan de förslag jag gillade och ogillade.
Skillnaden var också statistiskt säkerställd enligt det kriterium vi hade bestämt före provet.
Det betyder inte att EffNet har lärt sig en universell definition av musikalisk likhet. Det betyder att den, i det här försöket, bättre förutsade mina bedömningar av min musik.
Och det var precis det vi ville åstadkomma.
Konsten att inte föreslå någonting
Det återstod emellertid ett problem.
Även om EffNet var bättre på att sortera låtarna kunde den fortfarande föreslå sådant som jag inte tyckte var tillräckligt likt.
Och här insåg jag att vi hade byggt in ett ganska märkligt antagande i musikspelaren.
Om jag bad om fler låtar som liknade en viss låt skulle systemet alltid försöka ge mig ett antal förslag.
Men varför?
Anta att jag går in i en bokhandel och ber om en roman som liknar en mycket speciell bok.
Bokhandlaren letar i hyllorna och hittar ingenting som riktigt passar.
Vad vill jag då helst höra?
Att han inte hittade något?
Eller att han ändå räcker mig tio böcker eftersom datorsystemet kräver att listan ska innehålla tio titlar?
Jag föredrar nog det första.
En rekommendation är trots allt inte särskilt värdefull om den bara finns där för att fylla en plats.
Så vi bestämde oss för att musikspelaren skulle få lov att vara tyst.
I stället för att alltid visa ett bestämt antal låtar satte vi en gräns för hur lika de måste vara.
Om bara tre kandidater nådde över gränsen skulle listan innehålla tre låtar.
Om ingen klarade kravet skulle listan vara tom.
Det låter kanske som en liten förändring.
Men filosofiskt är den ganska betydande.
Vi gick från att fråga vilka låtar som var mest lika till att fråga vilka som var tillräckligt lika.
Det är inte samma sak.
Den minst dåliga kandidaten behöver inte vara bra.
Så fungerar musikspelarens rekommendationer nu
När jag väljer Fler som denna arbetar två AI-modeller tillsammans.
CLAP hämtar de 200 närmaste låtarna ur vektordatabasen Milvus.
Discogs-EffNet jämför dessa kandidater med ursprungslåten och rangordnar dem efter sin egen bedömning av musikalisk likhet.
Kandidater under likhetsgränsen 0,88 sorteras bort.
Högst 25 låtar visas, men listan kan innehålla betydligt färre – eller vara helt tom.
Gränsen är ett praktiskt val, inte en absolut musikalisk naturlag. Den kan justeras när erfarenheten ger anledning till det.
Det där med att räkna på all musik
Att hitta en bättre modell är förstås trevligt.
Men det finns en liten praktisk detalj när man har en musiksamling med ganska många låtar. Decennier av musiksamlande och sena nätter med LP eller CD-spelaren kopplad till datorn har resulterat i en viss volym.
Alla måste analyseras.
Igen.
Nu är det här inte första gången musikspelaren har utsatts för en sådan operation. Genom åren har jag låtit olika modeller tugga sig igenom samlingen för att skapa allt från genreinformation till ljudegenskaper och vektorer för sökning.
Men den här gången såg det först ut att bli ovanligt tidskrävande.
Den första implementationen var så långsam att hela arbetet riskerade att ta flera dygn.
Och det visade sig inte bero på att modellen var särskilt tung.
Det var snarare ett klassiskt programmeringsproblem: vi matade den på ett synnerligen ineffektivt sätt.
Modellen var byggd för att hantera ljud i bestämda grupper. Våra korta musikavsnitt fyllde bara en liten del av varje grupp, så större delen av beräkningen ägnades åt utfyllnad.
Det var ungefär som att skicka en lastbil tvärs över landet med ett enda paket i lasten.
Lösningen var att packa bättre.
Genom att låta flera låtars ljudavsnitt dela på samma beräkning kunde vi utnyttja modellen betydligt effektivare.
En viktig kontroll var förstås att optimeringen inte ändrade resultatet.
Det gjorde den inte.
Samma musik gav samma vektorer, bara mycket snabbare.
Sedan hittade vi nästa flaskhals.
Nätverket.
När beräkningarna väl gick fortare upptäckte vi att hämtningen av musik från lagringen tog över som begränsande faktor.
Så det blev sladd i stället för wifi.
Även om det inte löste allt.
Den verkliga genomkörningen blev långsammare än de första testerna hade antytt, men till slut var samlingen färdiganalyserad.
Drygt ett och ett halvt dygns arbete.
En ganska ansenlig insats för att få en knapp i musikspelaren att ge lite bättre förslag.
Men å andra sidan hade det varit betydligt mindre roligt att bara acceptera att knappen fungerade halvbra.
När musikspelaren fick sitt andra öra
När alla låtar hade fått sina nya vektorer återstod egentligen bara att koppla ihop delarna.
CLAP fick fortsätta sköta sökningen efter liknande kandidater.
EffNet fick ta över den slutliga rangordningen.
Vi provade först en ganska sträng gräns.
Resultatet blev nästan komiskt återhållsamt.
Don’t Cry fick i princip bara en annan version av sig själv som förslag.
Kamelots The Human Stain fick ingenting alls.
Det var kanske lite väl försiktigt.
Efter att ha lyssnat på resultatet och justerat gränsen något började listorna kännas mer användbara.
Fortfarande korta.
Fortfarande ibland tomma.
Men med betydligt färre låtar som fick mig att undra vad musikspelaren egentligen hade hört.
Jag kunde förstås ha fortsatt.
Det går alltid att bygga ytterligare ett test, prova fler modeller eller finjustera ännu en parameter.
Men någonstans måste man bestämma sig för att något är tillräckligt bra för att användas.
Så det fick bli:
Det här är bra. Vi kör på det så länge.
Och där står vi nu.
Vad var det egentligen vi lärde oss?
Det mest intressanta med hela experimentet är kanske att det inte slutade med att vi hittade den bästa AI-modellen för musik.
Vi hittade snarare flera modeller som var bra på olika saker.
CLAP hade ett slags öra. Det kunde höra övergripande stil, genre och musikalisk karaktär. Det kunde också koppla samman musik med språkliga beskrivningar, vilket gjorde det användbart för sökning.
MuQ hade ett annat. Det kunde i vissa situationer känna igen mer specifika musikaliska mönster, som riff och fraser.
EffNet hade ett tredje. Det var bättre på att urskilja den musikaliska understil som ofta avgör om två låtar verkligen känns besläktade.
Ingen av dem hade nödvändigtvis fel.
De svarade bara på lite olika frågor.
Och där finns en lärdom som sträcker sig långt utanför musikspelare.
Det är fullt möjligt att bygga ett system som mäter något med stor precision, men ändå inte mäter det man egentligen ville veta.
CLAP hade aldrig lovat att dess närmaste granne i vektorrymden också skulle vara den låt jag helst ville höra efter den jag spelade.
Det antagandet hade jag gjort själv.
Och det tog ganska många experiment innan jag förstod skillnaden.
Den andra lärdomen handlar om vad som händer när man faktiskt frågar användaren.
Hela arbetet tog en ny riktning när vi slutade försöka bevisa vilken matematisk metod som borde fungera bäst och i stället samlade in verkliga bedömningar.
Ett par hundra tummar upp och ned visade sig vara värdefullare än åtskilliga timmar av spekulation om hur vektorer borde jämföras.
Och när vi väl hade dessa bedömningar kunde vi prova nya modeller utan att jag behövde lyssna på samma låtar om och om igen.
Det tredje är kanske lite mer filosofiskt.
Vi människor har en ganska god förmåga att känna igen sådant som liknar något vi redan känner till.
Men vi är inte alltid särskilt bra på att förklara exakt varför.
Jag kan höra två låtar och omedelbart uppfatta att de hör ihop. Men om någon ber mig formulera en exakt matematisk definition av likheten blir det betydligt svårare.
Är det gitarrljudet? Sångarens frasering? Harmoniken? Tempot? Produktionen? Eller något slags helhetsintryck som uppstår genom samspelet mellan allt detta?
Förmodligen lite av varje.
Och kanske dessutom olika saker beroende på vilken musik vi talar om.
Det är en av anledningarna till att jag tycker att experimentet blev så intressant.
Vi började med att försöka hitta ett bättre sätt att räkna.
Vi slutade med att försöka förstå vad vi egentligen hörde.
Ett öra är ingen naturlag
Det finns förstås en begränsning i allt detta.
Det är mitt öra vi har tränat systemet mot.
Min musiksmak, min samling och min uppfattning om vad som är tillräckligt likt.
En annan lyssnare skulle kanske ge andra svar.
Någon som främst lyssnar efter rytm och dansbarhet skulle kunna göra helt andra bedömningar än någon som fokuserar på sångmelodier eller gitarrsound.
Det betyder inte att resultatet är meningslöst.
Tvärtom.
Musikspelaren är min privata leksak.
Det finns ingen anledning att låtsas att den måste upptäcka en universell och objektiv definition av musikalisk likhet.
Det räcker att den blir bättre på att förstå vad jag menar.
Och nästa gång jag hittar en modell som verkar lovande finns nu både lyssningsproven och bedömningarna kvar.
Då behöver vi inte börja med att gissa.
Vi kan fråga örat igen.
Epilog: En liten seger för tystnaden
Det finns en detalj i den färdiga lösningen som jag tycker särskilt mycket om.
Inte att den använder två AI-modeller.
Inte att den har analyserat alla mina låtar eller att den kan jämföra dem på bråkdelen av en sekund.
Utan att den ibland inte föreslår någonting alls.
Det är faktiskt ganska befriande.
I en värld där digitala system ständigt försöker rekommendera mer, föreslå mer och hålla oss sysselsatta lite längre har min musikspelare fått lära sig att ibland säga:
Nej. Jag hittade faktiskt inget som jag tycker är tillräckligt likt.
Och för en maskin som från början var byggd för att alltid ha ett svar är det kanske ett ganska stort steg framåt.